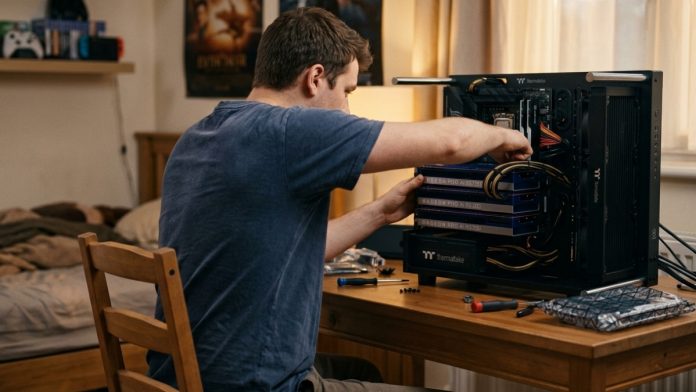
Executar modelos avançados de inteligência artificial sem depender de serviços na nuvem exige bastante poder computacional. Um entusiasta resolveu enfrentar esse desafio montando um computador com quatro placas Radeon, 128 GB de memória gráfica e uma configuração capaz de alcançar 1.192 tokens por segundo em um teste com múltiplas solicitações simultâneas.
O resultado foi compartilhado pelo usuário u/brainchillzZ na comunidade r/LocalLLM, no Reddit. A máquina foi preparada para executar modelos de linguagem localmente, reunindo as quatro placas de vídeo para trabalhar em conjunto.
O teste utilizou o modelo Qwen3.8-Flash-Next, descrito na publicação como uma arquitetura com aproximadamente 180 bilhões de parâmetros. O desempenho variou conforme a quantidade de fluxos simultâneos processados pelo computador.
Mas a montagem não chamou atenção apenas pelos números: o projeto também ganhou um detalhe doméstico bastante curioso, relacionado ao gato do proprietário e à refrigeração do gabinete.
Quatro placas Radeon trabalham juntas para executar inteligência artificial
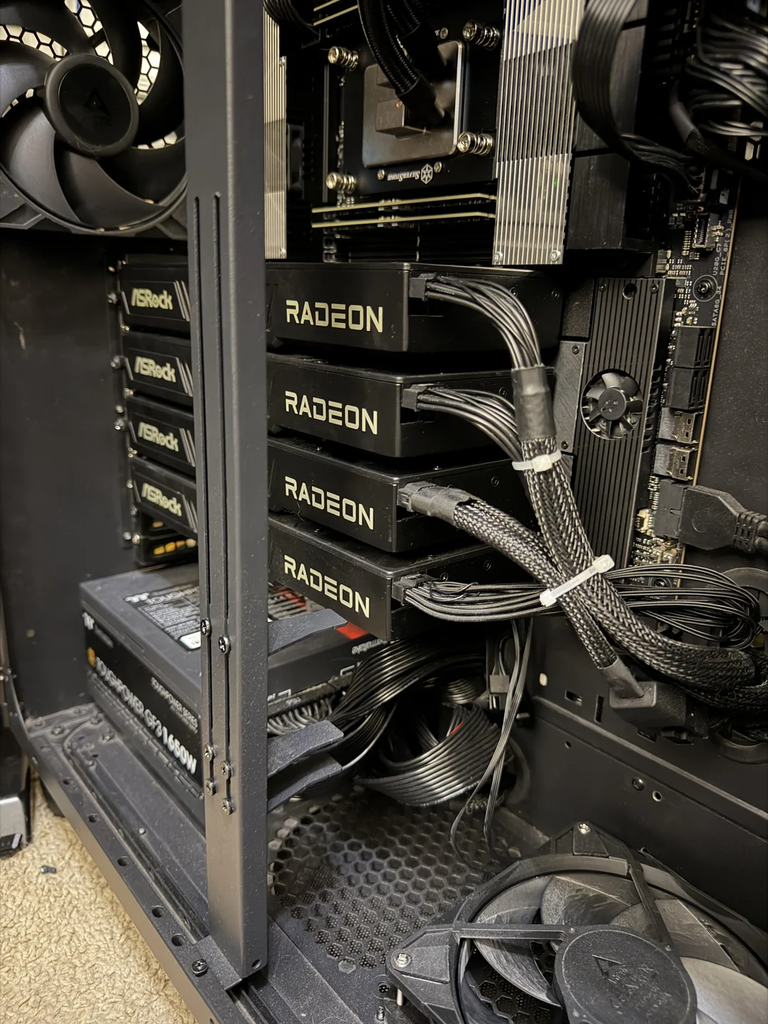
O computador utiliza quatro Radeon AI PRO R9700, cada uma equipada com 32 GB de VRAM. Somadas, as placas oferecem 128 GB de memória gráfica, recurso importante para executar modelos grandes de inteligência artificial.
A configuração inclui ainda 122 GB de memória RAM, Ubuntu 26.04 e um kernel Linux 7.0, conforme as informações compartilhadas pelo proprietário. As placas estão conectadas por interfaces PCI Express 5.0 x16.
O entusiasta também informou ter limitado o consumo de cada GPU a 211 W. Nesse limite, as quatro placas podem consumir aproximadamente 844 W no total, sem contar processador, sistema de refrigeração, armazenamento e outros componentes.
O objetivo da montagem é executar o modelo de linguagem localmente, mantendo seus dados e o processamento na própria máquina, em vez de depender exclusivamente de um serviço remoto.
Mudança no software elevou a velocidade dos testes
Antes de experimentar uma nova ferramenta, o proprietário utilizava o llama.cpp para executar o modelo. Segundo seu relato, a configuração anterior alcançava entre 65 e 75 tokens por segundo, mesmo com técnicas de geração especulativa.
A mudança veio com o Radiance, mecanismo de inferência desenvolvido em C++ e HIP que permite distribuir o processamento entre as quatro GPUs por meio de paralelismo tensorial.
Com a nova configuração, os resultados divulgados foram:
| Fluxos simultâneos | Velocidade agregada |
|---|---|
| 1 | 236 tokens/s |
| 2 | 371 tokens/s |
| 4 | 591 tokens/s |
| 8 | 890 tokens/s |
| 16 | 1.192 tokens/s |
Os números representam a geração total de tokens por segundo no conjunto da máquina. Portanto, o resultado de 1.192 tokens por segundo não significa que cada solicitação individual tenha recebido essa velocidade.
A diferença é importante porque o teste com 16 fluxos mede a capacidade de atender várias solicitações simultaneamente. Já o resultado de um único fluxo ajuda a observar o desempenho em uma situação com apenas uma solicitação ativa.
Segundo os resultados apresentados pelo proprietário, a nova configuração também elevou substancialmente a velocidade de geração em comparação com os testes anteriores realizados com o llama.cpp. Como os mecanismos de inferência são diferentes, a comparação deve ser entendida dentro das condições relatadas, e não como uma medida universal de desempenho.
O que os 128 GB de VRAM permitem fazer?
Um dos desafios de executar modelos grandes de linguagem em computadores próprios é acomodar seus pesos na memória disponível.
O modelo utilizado nos testes possui arquitetura Mixture of Experts (MoE), na qual diferentes especialistas são ativados conforme a necessidade de processamento. O proprietário informou ter utilizado uma versão quantizada, com arquivo de aproximadamente 113,6 GiB.
Com o processamento distribuído, os pesos do modelo são divididos entre as quatro GPUs. A memória também precisa acomodar estruturas auxiliares, como o cache KV, usado para manter informações necessárias durante a geração de respostas.
De acordo com os dados compartilhados, cada placa disponibilizava aproximadamente 12,74 GiB para esse cache. Esse espaço pode ajudar a manter contextos extensos e várias sessões de uso, embora a capacidade efetiva dependa da configuração e das condições de execução.
A montagem mostra como a memória gráfica pode ser determinante para rodar modelos grandes localmente. Ainda assim, ter 128 GB de VRAM não garante, por si só, uma velocidade específica: o resultado depende também do modelo, da quantização, do software e da forma como o trabalho é distribuído.
Quatro GPUs juntas superaram duas instâncias independentes no teste
O proprietário também testou uma configuração alternativa, dividindo as quatro Radeon em dois grupos de duas placas. A ideia era executar duas instâncias independentes do modelo e verificar se a divisão conseguiria atender mais solicitações.
Nos testes divulgados com a mesma quantidade de fluxos simultâneos, a configuração unificada apresentou resultados superiores.
Com 16 fluxos, as quatro GPUs trabalhando juntas alcançaram 1.192 tokens por segundo. Já as duas instâncias independentes registraram 917 tokens por segundo.
Segundo o relato, uma das diferenças estava relacionada à movimentação de dados entre a memória RAM e as GPUs na configuração dividida. Com as quatro placas trabalhando na mesma instância, os componentes do modelo permaneciam distribuídos pela memória gráfica.
A comparação, porém, tem um limite: a configuração dividida conseguiu executar 32 fluxos simultâneos e atingir 1.280 tokens por segundo, mas ainda não havia sido realizado um teste equivalente com as quatro GPUs unificadas nessa mesma quantidade de fluxos.
Por isso, os resultados disponíveis não permitem concluir que uma configuração será superior em todas as cargas de trabalho. Eles mostram apenas como as duas alternativas se comportaram nos cenários efetivamente testados.
O gato do proprietário ajudou a mudar o gabinete
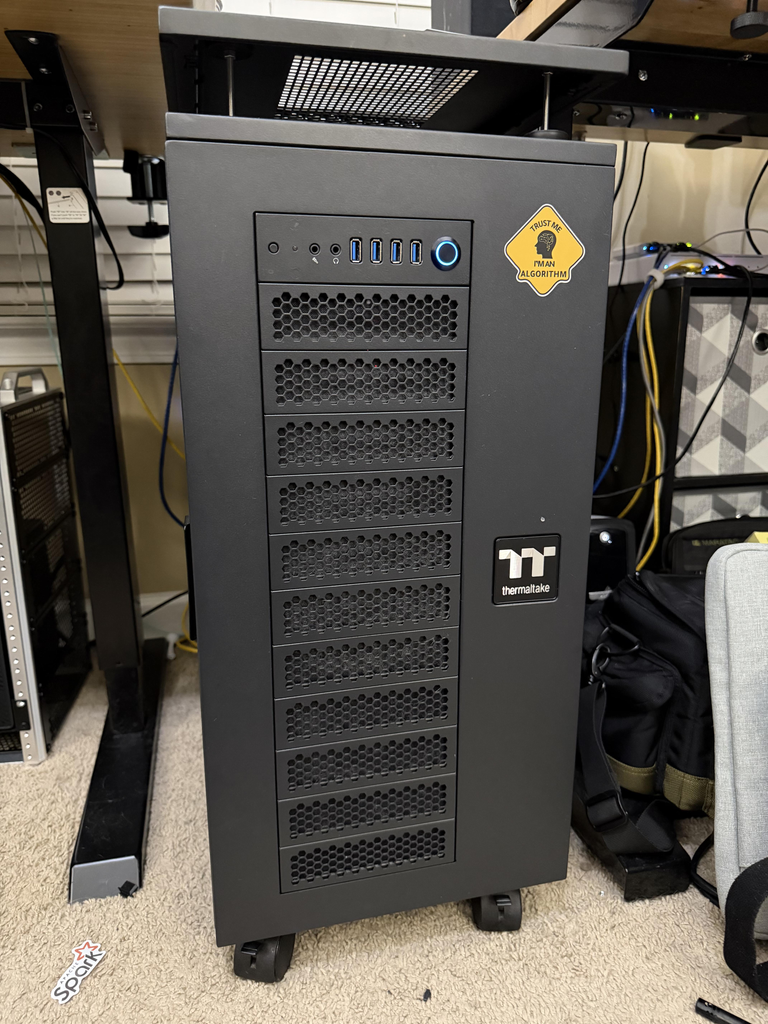
Além do hardware e dos testes de desempenho, um detalhe da montagem chamou atenção nas fotografias: uma cobertura elevada instalada sobre o gabinete.
O proprietário contou que comprou uma segunda tampa para o gabinete Thermaltake e utilizou hastes de aço e ímãs de neodímio para criar uma estrutura suspensa aproximadamente 3,8 centímetros acima da cobertura original.
O motivo foi o gato da casa, que costumava deitar sobre o computador e bloquear a saída de ar quente do radiador de 360 mm instalado na parte superior.
A adaptação foi feita para permitir que o ar continuasse escapando mesmo quando o animal escolhesse o gabinete como lugar de descanso.
O episódio dá um toque doméstico a uma montagem voltada a uma tarefa bastante exigente: executar modelos grandes de inteligência artificial em um computador próprio.
No fim, o projeto reúne quatro placas Radeon, 128 GB de VRAM e uma configuração de software que alcançou 1.192 tokens por segundo com 16 fluxos simultâneos. E mostra que, quando o computador também vira o lugar favorito do gato, até a refrigeração pode exigir uma solução criativa.